Amazon EKS
はじめに
本サイトにつきまして、【IT技術の知見】はじめに - 俺の技術ノート をご認識のほど宜しくお願いいたします。
01. 概要
Kubernetes のコントロールプレーンを AWS が管理し、コンテナ化したアプリケーションを実行できるサービスである。
02. 仕組み
コントロールプレーン
▼ コントロールプレーンとは
コンテナオーケストレーションを実行する環境を提供する。
データプレーンの Amazon VPC 外に存在している。
▼ コントロールプレーンの仕組み
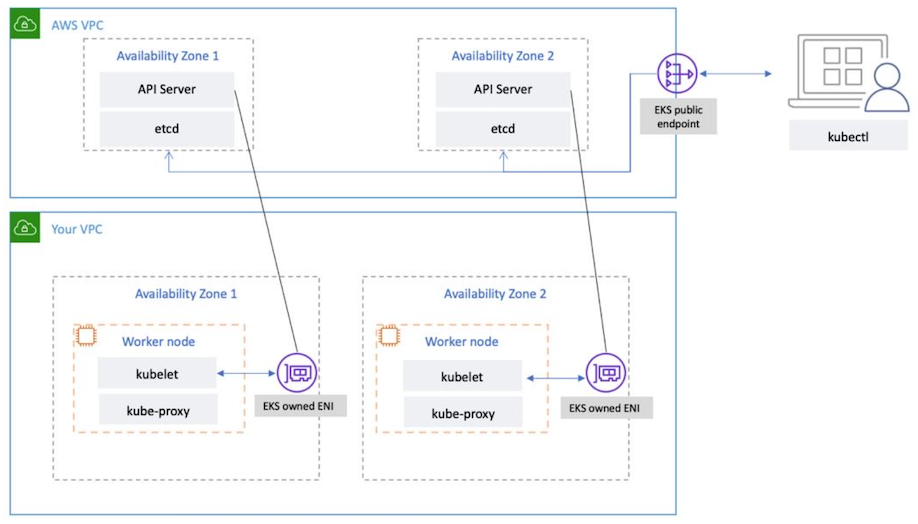
Amazon EKS のコントロールプレーンは、開発者や他の AWS リソースからのリクエストを待ち受ける API、接続を API にルーティングする NLB、データプレーンを管理するコンポーネントからなる。
データプレーン
▼ データプレーンとは
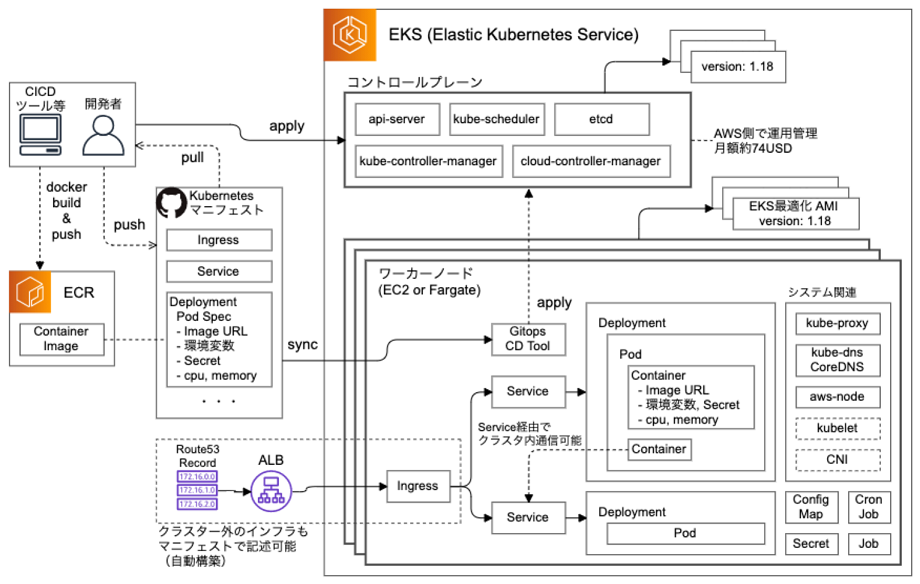
複数のホスト (Amazon EC2、Fargate) の OS 上でコンテナオーケストレーションを実行する。
『on EC2』『on Fargate』という呼び方は、データプレーンが Amazon EKS の実行環境 (on environment) の意味合いを持つからである。
コントロールプレーンのコンポーネント
▼ 対応関係
| コントロールプレーン上の AWS リソース | Kubernetes リソース | 補足 |
|---|---|---|
| Amazon EKS コントロールプレーン | コントロールプレーン Node | https://docs.aws.amazon.com/eks/latest/userguide/platform-versions.html |
| kube-apiserver | kube-apiserver | |
| kube-apiserver のロードバランサー (例:HAProxy) | NLB |
▼ コントロールプレーン Node
コントロールプレーン Node は、ユーザーの管理外の Amazon VPC に所属している。
▼ NLB
Amazon EKS コントロールプレーンでは、NLB が kube-apiserver の前段に位置し、複数の kube-apiserver にリクエストを分散する。
データプレーンのコンポーネント
▼ 対応関係
▼ Amazon EKS Cluster
▼ Amazon EKS Cluster とは
Fargate ワーカーNode や Amazon EC2 ワーカーNode の管理グループ単位のこと。
Kubernetes Cluster に相当する。
03. セットアップ
クラスターの基本設定
クラスター名、Kubernetes バージョン、クラスター IAM ロールを指定する。
| 設定 | 役割 |
|---|---|
| クラスター名 | Amazon EKS Cluster を識別する。 |
| Kubernetes バージョン | コントロールプレーンで使用する、Amazon EKS がサポートするバージョンを指定する。 |
| クラスター IAM ロール | Amazon EKS がクラスターの AWS リソースを管理するために引き受けるロールを指定する。サービスリンクロールとは異なる。 |
Terraformによる構築
ここでは、Terraform の公式モジュールを使用する。
module "eks_foo" {
  source = "terraform-aws-modules/eks/aws"

  version = "<モジュールのバージョン>"

  cluster_name    = "foo-eks-cluster"
  cluster_version = "<Kubernetesのバージョン>"

  # kube-apiserverをプライベートアクセスにするか否か
  cluster_endpoint_private_access = true

  # kube-apiserverにパブリックリクエストできるか否か
  cluster_endpoint_public_access = false

  # Amazon EKS Clusterのkube-apiserverにリクエストを送信できるCIDR
  cluster_endpoint_public_access_cidrs = ["*.*.*.*/32", "*.*.*.*/32", "*.*.*.*/32"]

  # Amazon CloudWatch Logsに送信するログの種類
  cluster_enabled_log_types = ["api", "audit", "authenticator", "controllerManager", "scheduler",]

  # ログの保管期間
  cluster_log_retention_in_days = 365

  # セキュリティグループを作成するか否か
  cluster_create_security_group = true

  # セキュリティグループのID
  cluster_security_group_id = "*****"

  # IRSAを有効化するか否か
  enable_irsa = true

  # ワーカーNodeのセキュリティグループを作成するか否か
  worker_create_security_group = true

  # Amazon VPCのID
  vpc_id = "vpc-*****"

  # サブネットのID
  subnets = ["subnet-*****", "subnet-*****", "subnet-*****"]

  # Amazon EKSアドオン
  addons = {

    coredns = {
      resolve_conflicts = "OVERWRITE"
    }

    kube-proxy = {
      resolve_conflicts = "OVERWRITE"
    }

    vpc-cni = {
      resolve_conflicts = "OVERWRITE"
    }
  }

  # Amazon EKSマネージドグループ
  eks_managed_node_groups = {
    foo-group = {
      instance_types = ["m5.large"]
      min_size     = 3
      max_size     = 4
      desired_size = 5
    }
  }
}
Amazon EKS Cluster の資格情報の追加
kubectl コマンドで Amazon EKS Cluster を操作するためには、kubeconfig ファイルへ Cluster の資格情報を登録する必要がある。
-
AWS CLI に資格情報を設定する。
$ aws configure -
Amazon EKS Cluster の名前を指定して、
kubeconfigファイルに Cluster の資格情報を登録する。$ aws eks update-kubeconfig --region ap-northeast-1 --name foo-eks-cluster -
kubectlコマンドの向き先を、Amazon EKS Cluster の kube-apiserver に変更する。$ kubectl config use-context <ClusterのARN> -
kubectlコマンドの接続を確認する。$ kubectl get pod
04. クラスターへのアクセス制御
クラスター API エンドポイントの多層防御
クラスター外から Pod への管理アクセスにはネットワーク制限・認証・認可を組み合わせ、Pod から AWS リソースへのアクセスには EKS Pod Identity と AWS IAM ポリシーなどを使用する。
パブリックアクセスの許可 CIDR が 0.0.0.0/0 でも認証・認可は必要だが、IPv4 の送信元制限は働かない。
| 仕組み | 役割 |
|---|---|
| 許可 CIDR、プライベートアクセスとセキュリティグループ | API エンドポイントに接続できる送信元を制限する。 |
| AWS IAM の資格情報に基づくトークン | リクエスト元の AWS IAM ユーザーやロールを識別する。 |
| Kubernetes RBAC、Amazon EKS アクセスポリシー | 操作できる Kubernetes リソース、Namespace、操作の種類を制限する。 |
| EKS Pod Identity | ServiceAccount に関連付けた IAM ロールの一時的な資格情報を Pod に提供する。 |
| AWS IAM ポリシーなど | 操作できる AWS リソースと操作の種類を制限する。 |
flowchart TD
    developer(["開発者の端末<br>クラスター外の kubectl"])

    subgraph eks["EKS クラスター"]
        subgraph controlPlane["AWS が管理するコントロールプレーン"]
            endpoint("クラスター API エンドポイント<br>kube-apiserver")
        end

        subgraph worker["利用者の VPC 内のワーカーNode"]
            subgraph targetPod["接続先の Pod"]
                container["コンテナ"]
            end
            agent("EKS Pod Identity Agent")
            agent -.->|一時的な資格情報の提供| container
        end

        endpoint <--> container
    end

    s3[("Amazon S3<br>バケット / オブジェクト")]

    developer <-->|IP アドレス制限、認証・認可| endpoint
    container -->|認証・認可| s3

style targetPod rx:12,ry:12パブリックアクセス/プライベートアクセス
kube-apiserver のインターネットへの公開範囲を設定できる。
パブリックアクセスの場合、許可 CIDR によって、API エンドポイントに接続できる送信元 IP アドレスを制限できる。
プライベートアクセスの場合、Amazon VPC 内部や接続されたネットワークからリクエストでき、クラスターセキュリティグループによってアクセスを制限する。
パブリックアクセスの許可 CIDR は、プライベートエンドポイントには適用されない。
両方を有効にできるため、API エンドポイントをインターネットからアクセスできない状態にするには、パブリックアクセスを無効にする必要がある。
kube-apiserver の認証と認可
▼ aws-auth (ConfigMap) を経由した Kubernetes RBAC との連携
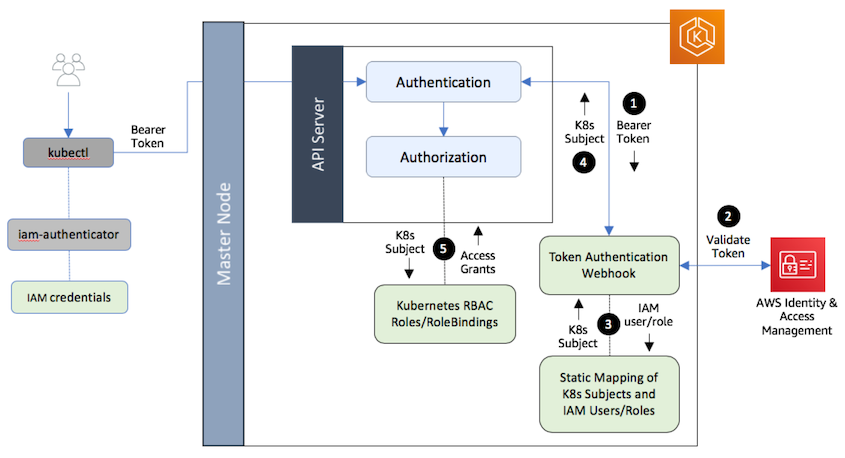
ConfigMap を経由して Kubernetes の RBAC と連携することにより、Kubernetes Cluster 外部の kube-apiserver クライアント (例:開発者、GitOps CD ツール、監視ツールなど) の認可スコープを制御する。
新しいアクセスエントリーよりもセットアップが難しい。
-
あらかじめ、kube-apiserver クライアント (
kubectlクライアント、Kubernetes リソース) に紐づく AWS IAM ユーザーを作成しておく。 -
AWS IAM ユーザーが kube-apiserver の URL にリクエストを送信する。
kube-apiserverは、aws-iam-authenticator-serverにWebhookリクエストを送信する。
admission-controllersアドオンのWebhookではないことに注意する。
-
コントロールプレーン Node 上の aws-iam-authenticator-server は、IAM API を使用して AWS IAM ユーザーを認証する。
-
もし認証に成功していた場合、aws-iam-authenticator-server は、ConfigMap (aws-auth) を確認する。
このConfigMapには、そのAWS IAMユーザーに紐づくUserAccount/ServiceAccount/Group/RoleBinding/ClusterRoleBindingが定義されている。
この時、Kubernetes Cluster外部のkube-apiserverクライアント (例:開発者、GitOps CDツール、監視ツールなど) の場合はUserAccount、Kubernetesリソースの場合はServiceAccountを取得する。
apiVersion: v1 kind: ConfigMap metadata: name: aws-auth namespace: kube-system data: mapAccounts: [] mapUsers: [] mapRoles: | - rolearn: arn:aws:iam::<AWSアカウントID>:role/foo-role # AWS IAM ロール名 username: hiroki-it # AWS IAM ユーザー名 groups: - system:masters # ClusterRoleBinding に定義された Group 名 - rolearn: arn:aws:iam::<AWSアカウントID>:role/bar-role # ワーカーNode に紐付けたロール名 username: system:node:{{EC2PrivateDNSName}} # ワーカーNode の識別子 groups: - system:bootstrappers - system:nodes -
aws-iam-authenticator-server は、UserAccount/ServiceAccount/Group、RoleBinding や ClusterRoleBinding の情報を含むレスポンスを kube-apiserver に返信する。
-
あとは、Kubernetes 標準の認可の仕組みである。
kube-apiserverは、UserAccount/ServiceAccount/Groupに紐づくRoleやClusterRoleを、RoleBindingやClusterRoleBindingを経由して取得する。
AWS IAMユーザーは、Kubernetesリソースを操作できる。
▼ プリンシパル AWS IAM ロールとアクセスエントリーを経由した Kubernetes Cluster の操作
▼ 概要
プリンシパル AWS IAM ロールとアクセスエントリーを使用することで、Kubernetes Cluster 外部の kube-apiserver クライアント (例:開発者、GitOps CD ツール、監視ツールなど) の認可スコープを制御する。
プリンシパル AWS IAM ロールとアクセスエントリーを使用する場合、従来の aws-auth (ConfigMap) と比較して、より簡単にセットアップできる。
プリンシパル AWS IAM ロールに紐づく Pod が Amazon EKS へ接続するとき、アクセスエントリーがこれを中継する。
Kubernetes リソースの認可スコープを IRSA で制御し、この仕組みのなかで、アクセスエントリーはアクセスエントリーポリシーを AWS IAM ロールに動的に紐づける。
▼ kubectl クライアント (例:開発者、ArgoCD など)
# Amazon EKS Clusterのkubectlクライアントとなる別のAmazon EKS Cluster

# ArgoCDのPodにスイッチロールの権限を持たせるためのAWS IAMロール
# 対象のAmazon EKS Clusterに接続するためのAWS IAMロールにスイッチロールできる
module "iam_assumable_role_with_oidc_argocd_access_entry_service" {

  source                        = "terraform-aws-modules/iam/aws//modules/iam-assumable-role-with-oidc"

  version                       = "<バージョン>"

  # ArgoCDのPodに紐付けるAWS IAMロール
  create_role                   = true
  role_name                     = "foo-argocd-access-entry-service"

  # Amazon EKS ClusterのOIDCプロバイダーURLからhttpsプロトコルを除いたもの
  # ArgoCDは外部のAmazon EKS Clusterで稼働している
  provider_url                  = replace(module.eks_argocd.cluster_oidc_issuer_url, "https://", "")

  # ArgoCDのPodのServiceAccount名
  # ServiceAccountは、Terraformではなく、マニフェストで定義したほうが良い
  oidc_fully_qualified_subjects = [
    # argocd applicaton-controller
    "system:serviceaccount:argocd:foo-argocd-application-controller",
    # argocd-server
    "system:serviceaccount:argocd:foo-argocd-server",
    ...
  ]
}

# 対象のAmazon EKS Clusterに接続するためのAWS IAMロール
# 対象のAmazon EKS Clusterでアクセスエントリーを設定する必要がある
module "iam_assumable_role_argocd_access_entry_cluster" {

  source               = "terraform-aws-modules/iam/aws//modules/iam-assumable-role"

  version              = "<バージョン>"

  create_role          = true
  role_name            = "foo-argocd-access-entry-cluster"

  trusted_role_actions = ["sts:AssumeRole"]

  trusted_role_arns    = [
    module.iam_assumable_role_with_oidc_argocd_access_entry_service.iam_role_arn
  ]

  role_requires_mfa    = false
}
Kubernetes Cluster 外部の kube-apiserver クライアント (例:開発者、GitOps CD ツール、監視ツールなど) の Amazon EKS Cluster のサーバー証明書を base64 方式エンコードした値 (-----BEGIN CERTIFICATE----- から -----END CERTIFICATE----- まで) を caData として設定する。
aws eks describe-cluster コマンドやコンソール画面から確認できる。
apiVersion: v1
kind: Secret
metadata:
  name: <クラスター名>
  labels:
    argocd.argoproj.io/secret-type: cluster
type: Opaque
data:
  config: |
    awsAuthConfig:
      clusterName": "<クラスター名>",
      roleARN: "<対象のAmazon EKS ClusterにアクセスするためのAWS IAMロールARN>"
    tlsClientConfig:
      insecure: false,
      caData: "<Amazon EKS Clusterのサーバー証明書をbase64方式エンコードした値>"
  name: "<クラスター名>"
  server: "https://*****.gr7.ap-northeast-1.eks.amazonaws.com"
▼ 宛先
# 宛先のAmazon EKS Clusterの設定

# 対象のAmazon EKS Clusterでアクセスエントリーを設定する
resource "aws_eks_access_entry" "argocd" {

  cluster_name      = aws_eks_cluster.foo_argocd.name

  principal_arn     = aws_iam_role.argocd.arn

  type = "STANDARD"
}

resource "aws_eks_access_policy_association" "argocd" {

  cluster_name = "foo-cluster"

  policy_arn    = "arn:aws:eks::aws:cluster-access-policy/AmazonEKSViewPolicy"

  principal_arn = aws_iam_role.argocd.arn

  access_scope {
    namespaces = "foo-namespace"
    type       = "namespace"
  }

  depends_on = [
    aws_eks_access_entry.argocd,
  ]
}

resource "aws_iam_role" "access_entry_argocd" {

  name = "access-entry-argocd"

  assume_role_policy = jsonencode({
    Version = "2012-10-17"
    Statement = [
      {
        Effect = "Allow"
        Principal = {
          AWS = "arn:aws:iam::*****:role/aws-reserved/sso.amazonaws.com/ap-northeast-1/AWSReservedSSO_*****"
        }
        Action = "sts:AssumeRole"
      }
    ]
  })
}
Kubernetes API データの暗号化
Kubernetes 1.28 以降の Amazon EKS では、Secret を含む Kubernetes API データを、AWS 所有の KMS キーによるエンベロープ暗号化で保護する。
独自にキーを管理する場合は、カスタマーマネージド KMS キーを指定できる。
05. Pod から AWS リソースへのアクセス
IRSA:IAM Roles for Service Accounts
▼ IRSA とは
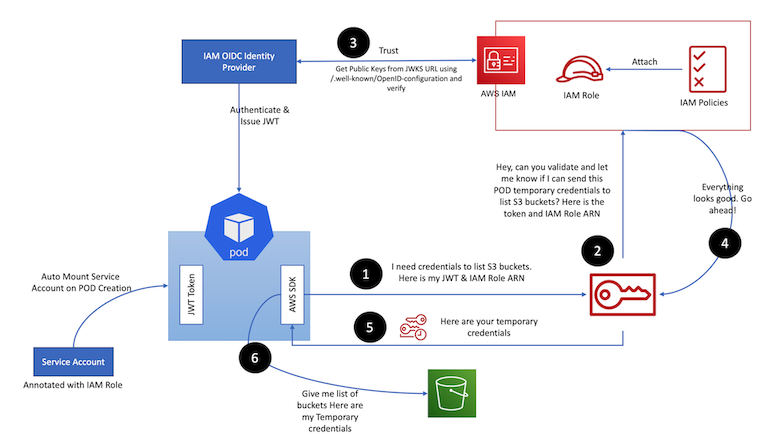
特に Kubernetes リソースの認可スコープを制御する仕組みのこと。
Kubernetes Cluster 外部の kube-apiserver クライアント (例:開発者、GitOps CD ツール、監視ツールなど) の認可スコープは、RBAC で制御する。
Amazon EKS を SSO の ID プロバイダーとして使用することで、IAM の認証フェーズを Amazon EKS に委譲する。
▼ セットアップ
ここでは、SSO の種類で OIDC を選ぶとする。
-
SSO の ID プロバイダーのタイプは、OIDC とする。
『Amazon EKS ClusterのOIDCプロバイダーURL』『OIDCプロバイダーのサーバー証明書を署名する中間認証局 (例:CertificateManagerなど) のサムプリント』『IDプロバイダーによるトークンの発行対象 (
sts.amazonaws.com) 』を使用して、OIDCプロバイダーを作成する。data "tls_certificate" "this" { url = module.foo_eks.cluster_oidc_issuer_url } # OIDCのIDプロバイダーをAWSに登録する。 resource "aws_iam_openid_connect_provider" "this" { url = module.foo_eks.cluster_oidc_issuer_url client_id_list = ["sts.amazonaws.com"] thumbprint_list = data.tls_certificate.this[0].certificates[*].sha1_fingerprint }apiVersion: v1 kind: Pod metadata: name: foo-pod spec: containers: - name: app image: app:1.0.0 volumeMounts: - mountPath: /var/run/secrets/kubernetes.io/serviceaccount name: kube-api-access-***** readOnly: "true" # OIDC のプロバイダーによるアクセストークンをコンテナにマウントする - mountPath: /var/run/secrets/eks.amazonaws.com/serviceaccount name: aws-iam-token readOnly: "true" volumes: - name: kube-api-access-***** projected: defaultMode: 420 sources: - serviceAccountToken: expirationSeconds: 3607 path: token - configMap: items: - key: ca.crt path: ca.crt name: kube-root-ca.crt - downwardAPI: items: - fieldRef: apiVersion: v1 fieldPath: metadata.namespace path: namespace # Amazon EKS を使用している場合、AWS-API へのリクエストに必要なトークンも設定される - name: aws-iam-token projected: defaultMode: 420 sources: - serviceAccountToken: # OIDC の ID プロバイダーによるトークンの発行対象 audience: sts.amazonaws.com expirationSeconds: 86400 path: token- Create an IAM OIDC provider for your cluster - Amazon EKS
- EKSのaws-authとかIRSAとか
- IAM Roles for Service Accounts を Terraformで手軽に体験してみる - onsd’s blog
- terraform-aws-eks/main.tf at v19.16.0 · terraform-aws-modules/terraform-aws-eks · GitHub
- Obtain the thumbprint for an OpenID Connect identity provider - AWS Identity and Access Management
-
IRSA で使用する AWS IAM ロールの信頼されたエンティティに、Amazon EKS Cluster の OIDC プロバイダーURL やユーザー名 (
system:serviceaccount:<Namespac名>:<ServiceAccount名>) を設定する。{ "Version": "2012-10-17", "Statement": [ { "Sid": "", "Effect": "Allow", "Principal": { "Federated": "arn:aws:iam::<AWSアカウントID>:oidc-provider/<Amazon EKS ClusterのOIDCプロバイダーURL>" }, // AssumeRoleWithWebIdentity を使用する "Action": "sts:AssumeRoleWithWebIdentity", "Condition": { // 完全一致 "StringEquals": { "<Amazon EKS ClusterのOIDCプロバイダーURL>:sub": [ "system:serviceaccount:<Namespac名>:<ServiceAccount名>" ] } } } ] } -
ServiceAccount の
.metadata.annotations.eks.amazonaws.com/role-arnキーで AWS IAM ロールの ARN を設定する。これにより、Amazon EKSで認証済みのServiceAccountにAWS IAMロールを紐付けられるようになる。
automountServiceAccountTokenキーが有効化されていることを確認する。apiVersion: v1 kind: ServiceAccount metadata: annotations: eks.amazonaws.com/role-arn: <AWS IAMロールのARN> name: <信頼されたエンティティで指定したユーザー名にあるServiceAccount名> namespace: <信頼されたエンティティで指定したユーザー名にあるNamespace名> automountServiceAccountToken: "true" -
Pod で、ServiceAccount 名を設定する。
apiVersion: v1
kind: Pod
metadata:
  name: foo-pod
  namespace: foo-namespace
spec:
  serviceAccountName: foo-sa
  containers: ...
もし .metadata.annotations.eks.amazonaws.com/role-arn キーを使用しない場合、Kubernetes リソースから AWS リソースへのアクセスがあったときは、Amazon EC2 ワーカーNode や Fargate ワーカーNode の AWS IAM ロールが使用される。
IRSA が登場するまでは、Amazon EKS 上でのワーカーNode (例:Amazon EC2、Fargate) にしか AWS IAM ロールを紐付けることができず、Kubernetes リソースに AWS IAM ロールを直接的に紐付けることはできなかった。
ServiceAccount のトークンは、コンテナにファイルとしてマウントされている。
$ printenv | sort -f

AWS_DEFAULT_REGION=ap-northeast-1
AWS_REGION=ap-northeast-1
AWS_ROLE_ARN=arn:aws:iam::<アカウントID>:role/argocd-reposerver
AWS_STS_REGIONAL_ENDPOINTS=regional
# ServiceAccountのトークン文字列が記載されたファイル
AWS_WEB_IDENTITY_TOKEN_FILE=/var/run/secrets/eks.amazonaws.com/serviceaccount/token

...
06. ネットワーク通信
VPC とサブネット
クラスターに VPC とサブネットを指定すると、Amazon EKS はコントロールプレーンとワーカーNode 間の通信用 ENI を、そのサブネットに作成する。
サブネットは、少なくとも 2 つの異なる AZ から指定する。
Cluster 内の IP アドレス
▼ IP アドレスファミリー
クラスターの IP アドレスファミリーで、Pod と Service に割り当てる IP アドレスを IPv4 または IPv6 から選択する。
Pod の IP アドレスと、Service に割り当てる ClusterIP は別のものである。
▼ Service のための IP アドレス
Service に割り当てる ClusterIP は、Service IP 範囲によって決まる。
IPv4 の場合、クラスター作成時に Service 用の CIDR を指定できる。
指定しない場合は通常、10.100.0.0/16 または 172.20.0.0/16 が使用される。ハイブリッドノードを使用する構成では、ネットワークの重複を避けるために別の CIDR が選択される場合がある。
$ kubectl get service -A jsonpath='{.spec.clusterIP}'

# IP範囲の中からServiceにIPアドレスを割り当てる
172.20.74.199
172.20.0.1
172.20.123.203
172.20.0.10
▼ Pod のための IP アドレス
Pod の IP アドレスは、Amazon EC2 の ENI とセカンダリープライベート IP アドレスに割り当てられる IP アドレスによって決まる。
Amazon VPC CNI 内の L-IPAM デーモンは、ENI とセカンダリープライベート IP アドレスの情報を CNI にプールする。
ネットワークアドオン
Amazon VPC CNI、CoreDNS、kube-proxy などを使用して、Pod のネットワーク、名前解決、Service の通信を構成する。
Amazon EKS アドオンとして管理する場合は、クラスターの Kubernetes バージョンと互換性のあるアドオンのバージョンを使用する。
サブネット内外へのリクエスト
Amazon EKS データプレーンはプライベートサブネットで稼働させ、パブリックネットワーク上の ALB から通信を受信するとよい。
このとき、パブリックネットワークにあるレジストリから、Istio や ArgoCD のコンテナイメージをプルできるように、Amazon EKS Fargate ワーカーNode と Internet Gateway 間のネットワークを繋げる必要がある。
そのために、パブリックサブネットに AWS NAT Gateway を配置する。
データプレーン内外へのリクエスト
▼ パブリックサブネット内のデータプレーンからのリクエスト
Pod をパブリックサブネットに配置した場合、パブリックネットワークや Amazon VPC 外にある AWS リソース (Amazon ECR、Amazon S3、AWS Systems Manager、Amazon CloudWatch Logs、DynamoDB など) へリクエストを送信するために特に必要なものはない。
このとき、POD_SECURITY_GROUP_ENFORCING_MODE=standard に設定された Amazon VPC CNI は SNAT 処理を実行し、クライアント側 Pod の送信元 IP アドレスを Amazon EC2 ワーカーNode のプライマリーENI (eth0) の IP アドレスに変換する。
▼ プライベートサブネット内のデータプレーンからのリクエスト
▼ Pod 外から内へのリクエスト
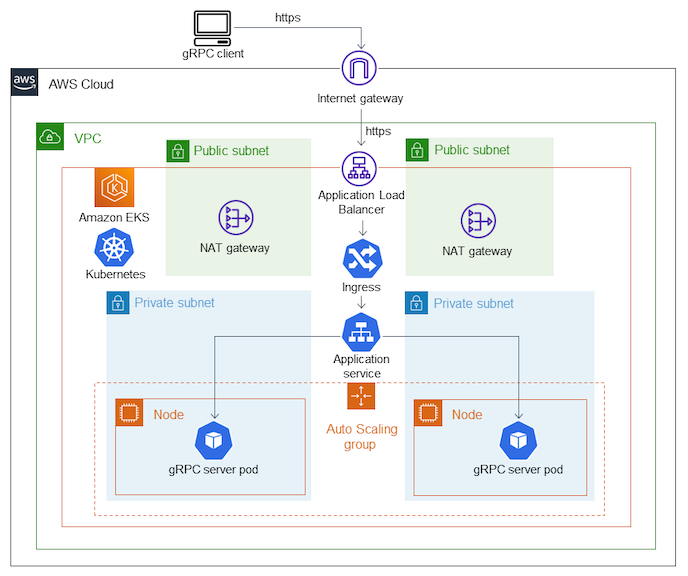
Pod をプライベートサブネットに配置した場合、プライベートサブネット外から内のデータプレーンへのリクエストを AWS Load Balancer Controller で受信し、AWS ALB を使用して Pod にルーティングする。
▼ 宛先情報の管理方法
リクエストの宛先情報は、Secret で管理し、Pod 内のコンテナにマウントする。
apiVersion: v1
kind: Secret
metadata:
  name: foo-secret
data:
  # RDS (Aurora) の宛先情報
  DB_HOST_PRIMARY: <プライマリーインスタンスのエンドポイント>
  DB_HOST_READ: <リードレプリカのエンドポイント>
  DB_USER: bar
  DB_PASSWORD: baz
  # SQS の宛先情報
  SQS_QUEUE_NAME: foo-queue.fifo
  SQS_REGION: ap-northeast-1
▼ Amazon VPC 外のほかの AWS リソースへのリクエスト
Pod をプライベートサブネットに配置した場合、パブリックネットワークや Amazon VPC 外にある AWS リソース (Amazon ECR、Amazon S3、AWS Systems Manager、Amazon CloudWatch Logs、AWS DynamoDB など) へリクエストを送信するためには、AWS NAT Gateway または Amazon VPC エンドポイントを配置する必要がある。
このとき、クライアント側 Pod の送信元 IP アドレスは、AWS NAT Gateway または Amazon VPC エンドポイントに紐づく IP アドレスとなる。
以下のようなエラーで Pod が起動しない場合、Pod が何らかの理由でコンテナイメージをプルできない可能性がある。
また、Pod が作成されない限り、ワーカーNode も作成されないことに注意する。
Pod provisioning timed out (will retry) for pod
▼ Amazon VPC 外のコントロールプレーンへのリクエスト
Amazon EKS Cluster を作成すると、ENI も作成する。
これにより、データプレーンが Amazon VPC 外のコントロールプレーンと通信できるようになる。
データプレーンがコントロールプレーンとリクエストを送受信する場合、コントロールプレーンのクラスターエンドポイントの設定 (パブリック、プライベート) によって、マネージドな Interface 型 Amazon VPC エンドポイントまたは AWS NAT Gateway が必要になる。
| Amazon VPC エンドポイントの接続先 | タイプ | プライベート DNS 名 | 説明 |
|---|---|---|---|
| Amazon EKS コントロールプレーン | (たぶん) Interface | マネージド | プライベートサブネット内の Amazon EC2 Node からコントロールプレーンのある Amazon VPC にリクエストを送信するため。 |
| Amazon CloudWatch Logs | Interface | logs.ap-northeast-1.amazonaws.com |
Pod 内のコンテナのログを POST リクエストを送信するため。 |
| Amazon ECR | Interface | api.ecr.ap-northeast-1.amazonaws.com*.dkr.ecr.ap-northeast-1.amazonaws.com |
コンテナイメージの GET リクエストを送信するため。 |
| Amazon S3 | Gateway | なし | コンテナイメージのレイヤーを POST リクエストを送信するため |
| AWS Systems Manager | Interface | ssm.ap-northeast-1.amazonaws.com |
AWS Systems Manager のパラメーターストアに GET リクエストを送信するため。 |
| AWS Secrets Manager | Interface | ssmmessage.ap-northeast-1.amazonaws.com |
Secrets Manager を使用するため。 |
▼ Amazon VPC 内のほかの AWS リソースへのリクエスト
Amazon VPC 内にある AWS リソース (RDS など) の場合、その AWS 側のセキュリティグループにて、Pod のプライベートサブネットの CIDR ブロックを許可すればよい。
コントロールプレーン内外へのリクエスト
▼ コントロールプレーンとワーカーNode のネットワーク
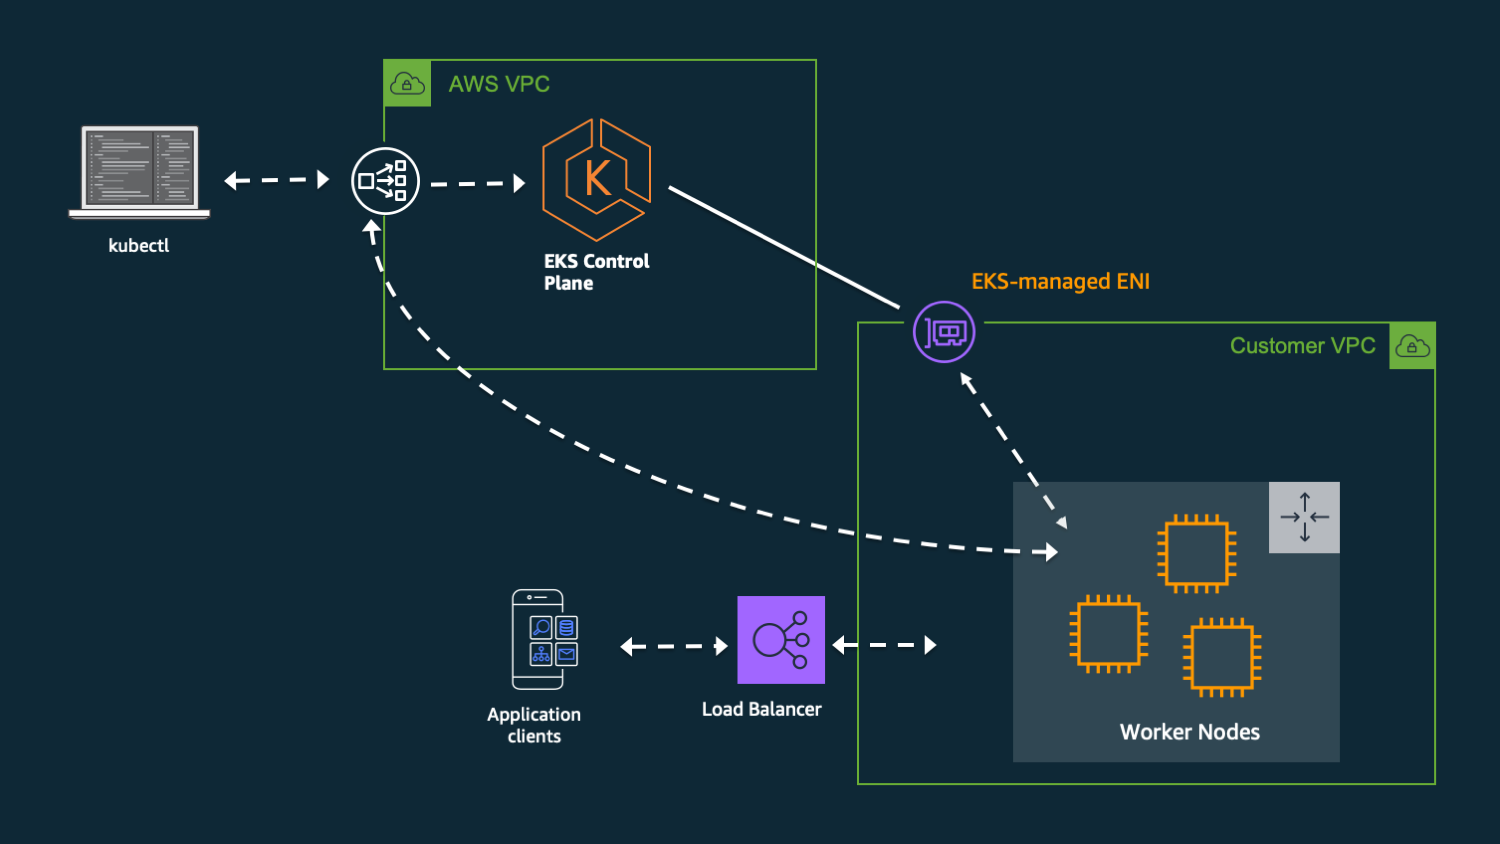
コントロールプレーンは Amazon VPC 外にあり、ワーカーNode は Amazon VPC 内にある。
kubectl コマンドやワーカーNode からのリクエストのエンドポイントとして NLB が配置されている。
この NLB を経由して、コントロールプレーン内の kube-apiserver にリクエストを送信できる。
Amazon VPC 外から NLB への 443 番ポートに対するネットワークからのリクエストはデフォルトでは許可されているが、拒否するように設定できる。
▼ クラスターセキュリティグループ
Amazon EKS は、eks-cluster-sg-<クラスター名>-<識別子> というクラスターセキュリティグループを作成し、コントロールプレーンの ENI などに関連付ける。
追加のセキュリティグループも指定できるが、すべての送信元 IP アドレスを許可する必要はなく、API、kubelet、DNS などに必要な通信を許可する。
クラスターセキュリティグループはプライベートエンドポイントへのアクセスに適用され、パブリックエンドポイントの接続元は許可 CIDR で制限する。
▼ クラスターエンドポイントのリクエスト制限
▼ パブリックのみの場合
基本的には、すべての IP アドレスから kube-apiserver にリクエストを送信できる。
プライベートサブネット内にワーカーNode がある場合、AWS NAT Gateway を経由して、kube-apiserver にリクエストを送信することになる。
▼ パブリックとプライベートの場合
パブリックとプライベートを許可する場合、指定した CIDR ブロックに含まれる IP アドレスからのみ、kube-apiserver にリクエストを送信できる。
プライベートサブネット内にワーカーNode がある場合、以下のいずれかの経路で kube-apiserver にリクエストを送信することになる。
- AWS NAT Gateway を経由して、AWS NAT Gateway を経由して、パブリック制限を通過する
- ENI (Interface 型の Amazon VPC エンドポイント) を経由して、プライベート制限を通過する
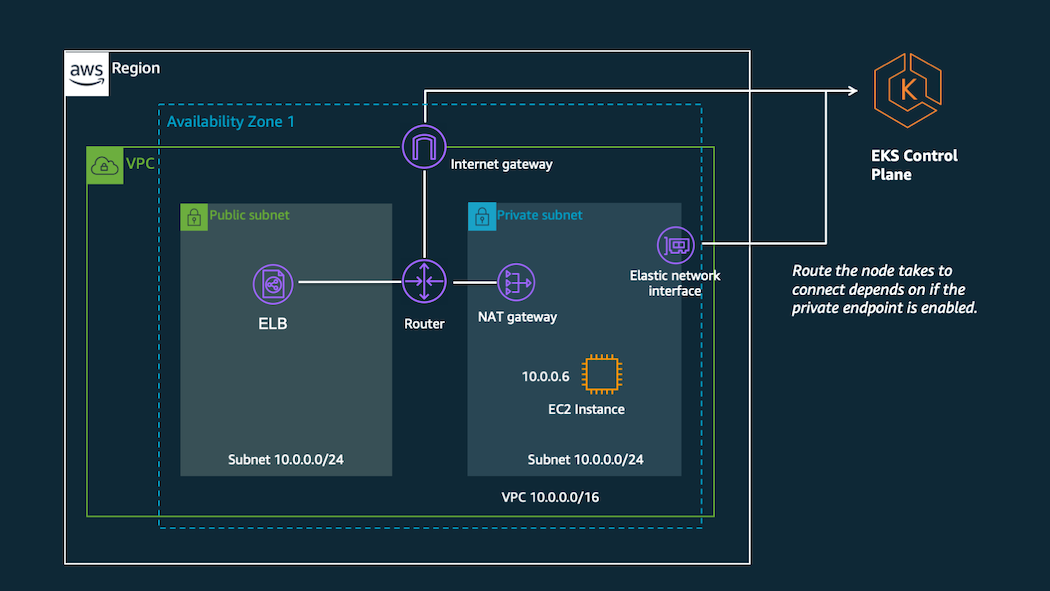
Amazon VPC 外の AWS リソース (例:Amazon EKS コントロールプレーン、Amazon ECR、Amazon S3、AWS Systems Manager、Amazon CloudWatch Logs、DynamoDB など) にリクエストを送信する場合、専用の Amazon VPC エンドポイントを設ける必要がある。
| Amazon VPC エンドポイントの接続先 | タイプ | プライベート DNS 名 | 説明 |
|---|---|---|---|
| Amazon EKS コントロールプレーン | (たぶん) Interface | マネージド | プライベートサブネット内の Amazon EC2 Node からコントロールプレーンのある Amazon VPC にリクエストを送信するため。 |
| Amazon CloudWatch Logs | Interface | logs.ap-northeast-1.amazonaws.com |
Pod 内のコンテナのログを POST リクエストを送信するため。 |
| Amazon ECR | Interface | api.ecr.ap-northeast-1.amazonaws.com*.dkr.ecr.ap-northeast-1.amazonaws.com |
コンテナイメージの GET リクエストを送信するため。 |
| Amazon S3 | Gateway | なし | コンテナイメージのレイヤーを POST リクエストを送信するため |
| AWS Systems Manager | Interface | ssm.ap-northeast-1.amazonaws.com |
AWS Systems Manager のパラメーターストアに GET リクエストを送信するため。 |
| Secrets Manager | Interface | ssmmessage.ap-northeast-1.amazonaws.com |
Secrets Manager を使用するため。 |
▼ プライベートのみの場合
プライベートのみを許可する場合、この NLB は閉じられ、Amazon VPC 内からしか kube-apiserver にリクエストを送信できなくなる。
プライベートサブネット内にワーカーNode がある場合、Amazon VPC エンドポイントを経由して、kube-apiserver にリクエストを送信することになる。
この状態で、kubectl コマンドを使用して kube-apiserver にリクエストを送信する方法は、以下のとおりである。
- ローカルマシンから
- Amazon VPC 内の踏み台 Amazon EC2 から
- Amazon VPC 内の Cloud9 から
07. ワーカーNode の管理
マルチワーカーNode
▼ マルチワーカーNode とは
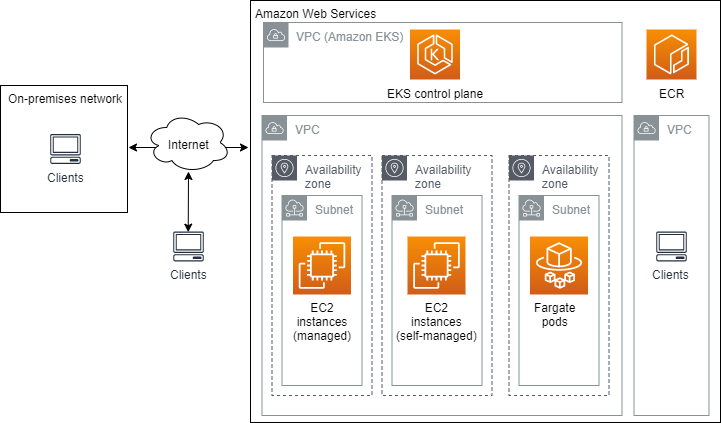
マルチワーカーNode を作成する場合、AZ ごとに Node を作成する。
▼ ワーカーNode 間のファイル共有
AWS EFS を使用して、ワーカーNode 間でファイルを共有する。
Pod のファイルはワーカーNode にマウントされるため、異なるワーカーNode 上の Pod 間でファイルを共有したい場合 (例:Prometheus のローカルストレージを Pod 間で共有したい) に役立つ。
ただしできるだけ、ワーカーNode をステートフルではなくステートレスにする必要があり、Pod のファイルはワーカーNode の外で管理する必要がある。
Amazon EC2 ワーカーNode
▼ Amazon EC2 ワーカーNode
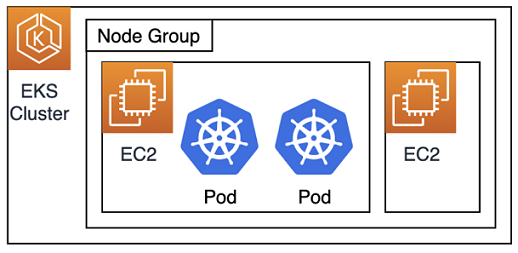
▼ Amazon EC2 ワーカーNode とは
Amazon EC2 で稼働する Kubernetes のホストのこと。
Fargate と比べてカスタマイズ性が高く、ワーカーNode 当たりで稼働する Pod 数に重み付けを設定できる。
一方で、各 Amazon EC2 のハードウェアリソースの消費量をユーザーが管理しなければならないため、Kubernetes のホストの管理が大変である。
▼ セットアップ
▼ IAM ポリシー
Amazon EC2 ワーカーNode が、自身の所属する Cluster にリクエストを送信できるように、Amazon EC2 ワーカーNode に AmazonEKSWorkerNodePolicy を付与する必要がある。
Amazon EC2 ワーカーNode 内の Pod が Amazon ECR からコンテナイメージをプルできるように、Amazon EC2 ワーカーNode に AmazonEC2ContainerRegistryReadOnly を付与する必要がある。
これにより、Pod のコンテナごとに AWS の資格情報をマウントする必要がなくなる。
aws-node の Pod が AWS のネットワーク系の API にリクエストを送信できるように、IRSA 用の ServiceAccount に AmazonEKS_CNI_Policy (IPv4 の場合) または AmazonEKS_CNI_IPv6_Policy (IPv6 の場合) を付与する必要がある。
Node グループ (on Amazon EC2)
▼ マネージド
▼ マネージド Node グループ
- Node グループ内の各 Amazon EC2 ワーカーNode の作成
- Node グループに紐づく AWS Auto Scaling グループの作成
- Amazon EC2 ワーカーNode の OS やミドルウェアの各種アップグレード
を自動化する。
Node グループは、Amazon EC2 ワーカーNode が配置されるプライベートサブネットの AZ にこれをスケジューリングさせるように、AWS Auto Scaling グループに各 AZ を自動的に設定する。
AWS Auto Scaling グループの機能を使用すれば、Amazon EC2 ワーカーNode の自動的な起動/停止やヘルスチェックを設定できる。
▼ Node グループの定期アクション
同じ Node グループの Amazon EC2 ワーカーNode の定期アクションを設定する。
Amazon EKS のテスト環境の請求料金を節約するため、昼間に通常の個数へスケールアウトし、夜間に 0 個へスケールインするようにすれば、ワーカーNode を夜間だけ停止させられる。
▼ 起動テンプレートと AWS Auto Scaling グループとの紐付け
マネージド Node グループは、あくまで Amazon EC2 Node のライフサイクルを管理するだけである。
Amazon EC2 Node の構成には起動テンプレートを使用し、独自のテンプレートを指定しない場合は Amazon EKS が既定のテンプレートを作成する。
独自の起動テンプレートでは、タグ付けを含む Amazon EC2 Node の設定を指定できる。
▼ セルフマネージド
▼ セルフマネージド Node グループ
起動テンプレートと AWS Auto Scaling グループを使用して、Amazon EC2 ワーカーNode の構成と台数を管理する。
- Node グループ内の各 Amazon EC2 ワーカーNode の作成
- Node グループに紐づく AWS Auto Scaling グループの作成
- Amazon EC2 ワーカーNode の OS やミドルウェアの各種アップグレード
をユーザーが管理する。
AWS Auto Scaling グループの機能を使用すれば、Amazon EC2 ワーカーNode の自動的な起動/停止やヘルスチェックを設定できる。
▼ Node 数の変更
Node グループ (マネージド Node グループ、セルフマネージド Node グループ) では、希望数を変更することで現在の Node 数を変更できる。
設定後、AWS Auto Scaling グループは希望数で設定した Node 数を維持する (Karpenter のドキュメントでは、これを『静的』と表現している)。
希望数のほかにも最大数と最小数を設定できるが、これらは実際には機能しない。
もし負荷の状況に応じてスケーリングしたい場合、Node のスケーリングツール (例:ClusterAutoscaler、Karpenter など) を使用しないと、最大数と最小数の設定に応じたスケーリングを実施してくれない。
▼ Amazon EC2 へのタグ付けの例
▼ マネージド Node グループ
| タグ | 値 | 説明 |
|---|---|---|
Name |
Amazon EC2 ワーカーNode の名前 | Node グループで指定する起動テンプレートのタグに、Name タグを設定しておく。Amazon EC2 ワーカーNode の名前は Name タグで決まるため、起動テンプレートでワーカーNode 名を設定できる。 |
▼ セルフマネージド Node グループ
| タグ | 値 | 説明 |
|---|---|---|
Name |
Amazon EC2 ワーカーNode の名前 | Amazon EC2 の名前は Name タグで決まる仕組みのため、Node グループに参加させる Amazon EC2 ワーカーNode の Name タグに、ワーカーNode 名を設定しておく。 |
kubernetes.io/cluster/<Amazon EKS Cluster名> |
owned |
セルフマネージド型の Amazon EC2 ワーカーNode が所属するクラスターを識別する。AWS Auto Scaling グループのタグをインスタンスへ伝播させて設定できる。 |
Amazon EC2 ワーカーNode のセットアップ (Terraform の場合)
▼ マネージド Node グループの場合
起動テンプレートを使用し、Amazon EC2 ワーカーNode を作成する。
# Nodeグループ
resource "aws_eks_node_group" "foo" {

  ...

  # Nodeグループの種類だけ、起動テンプレートを設定する
  launch_template {
    id      = aws_launch_template.foo1.id
    version = "$Latest"
  }

  launch_template {
    id      = aws_launch_template.foo2.id
    version = "$Latest"
  }

  ...
}

# 起動テンプレート
resource "aws_launch_template" "foo" {

  # タグ付けは任意である
  tag_specifications {
    tags = {
      Env  = var.environment
    }
  }

  ...
}

# Nodeグループのタグ
resource "aws_autoscaling_group_tag" "foo" {
  for_each = local.tags

  autoscaling_group_name = aws_eks_node_group.foo.name

  # Nodeグループに設定する全てのタグに対して適用する
  tag {
    key                 = each.key
    value               = each.value
    # 実装時点 (2023/06/06) で、マネージドNodeグループは自身の作成するAWS Auto Scalingグループにタグ付けできない
    # そのままではterraform planのたびに、AWS Auto Scalingグループにタグ付けしようとする差分がでてしまうため、Nodeグループ外からAWS Auto Scalingグループのタグ付けを有効化する
    # @see
    # https://github.com/aws/containers-roadmap/issues/608
    # https://github.com/terraform-aws-modules/terraform-aws-eks/issues/1558#issuecomment-1030633280
    propagate_at_launch = true
  }
}
▼ セルフマネージド Node グループの場合
任意の AutoScaling にて、起動テンプレートを使用して Amazon EC2 ワーカーNode を作成する。
resource "aws_autoscaling_group" "foo" {

  ...

  tag {
    key   = "Name"
    value = "foo-instance"
  }

  # AutoScalingのタグに kubernetes.io/cluster/<Amazon EKS Cluster名> をつける必要がある
  tag {
    key   = "kubernetes.io/cluster/<Amazon EKS Cluster名>"
    value = "owned"
  }

  # 起動テンプレートは任意である
  launch_template {
    id      = aws_launch_template.foo.id
    version = "$Latest"
  }

  ...
}
08. マシンイメージと Node の初期化
Amazon EC2 ワーカーNode の最適化 AMI
▼ Amazon EC2 ワーカーNode の最適化 AMI とは
任意の Amazon EC2 ワーカーNode を使用できるが、AWS が用意している最適化 AMI を選んだほうがよい。
この AWS AMI には、Amazon EC2 が Amazon EKS と連携するために必要なソフトウェアがプリインストールされており、Amazon EC2 ワーカーNode をセットアップする手間が省ける。
必ずしも、すべての Amazon EC2 ワーカーNode を同じ AWS AMI で構築する必要はない。
Amazon EC2 ワーカーNode を種類ごとに異なる AWS AMI で作成し、特定のアプリケーションを含む Pod は特定の Amazon EC2 ワーカーNode にスケジューリングさせる (例:計算処理系アプリは Amazon EKS 最適化高速 AMI の Amazon EC2 ワーカーNode 上で動かす) といった方法でもよい。
▼ Amazon EKS 最適化 Amazon Linux
Amazon EKS のための標準的な Amazon EC2 を作成できる。推奨方式である。
aws ssm get-parameter コマンドを使用すると、公式が提供するマシンコンテナイメージの ID を確認できる。
注意点として、AWS AMI のマイナーバージョンは固定できるが、パッチバージョンは固定できない。
そのため、パッチバージョンがアップグレードされるたびに、AWS AMI の ID は変わる。
AWS AMI の ID を固定するためには、AWS AMI をダウンロードして自前で管理する必要がある。
$ aws ssm get-parameter \
    --name /aws/service/eks/optimized-ami/<バージョン>/amazon-linux-2/recommended/image_id \
    --region ap-northeast-1 \
    --query "Parameter.Value" \
    --output text
▼ Amazon EKS 最適化高速 Amazon Linux
GPU が搭載された Amazon EC2 や Amazon EC2 Inf1 インスタンスを作成できる。
GPU が必要なアプリケーションの含む Pod (計算処理系、機械学習系のアプリケーション) と相性がよい。
▼ Amazon EKS 最適化 ARM Amazon Linux
ARM ベースのプロセッサーが搭載された Amazon EC2 を作成できる。
▼ Amazon EKS 最適化 Bottlerocket AMI
コンテナに特化した Amazon EC2 を作成できる。
$ aws ssm get-parameter \
    --name /aws/service/bottlerocket/aws-k8s-<バージョン>/x86_64/latest/image_id \
    --region ap-northeast-1 \
    --query "Parameter.Value" \
    --output text
Amazon EC2 ワーカーNode のカスタム AMI
▼ Amazon EC2 ワーカーNode のカスタム AMI とは
Amazon EC2 ワーカーNode の最適化 AMI ではない AWS AMI のこと。
kubelet-config.json ファイル (KubeletConfiguration)
Amazon EC2 ワーカーNode の kubelet を設定する。
{
  "kind": "KubeletConfiguration",
  "apiVersion": "kubelet.config.k8s.io/v1beta1",
  "address": "0.0.0.0",
  "authentication": {
    "anonymous": {"enabled": "false"},
    "webhook": {"cacheTTL": "2m0s", "enabled": "true"},
    "x509": {"clientCAFile": "/etc/kubernetes/pki/ca.crt"}
  },
  "authorization": {
    "mode": "Webhook",
    "webhook": {"cacheAuthorizedTTL": "5m0s", "cacheUnauthorizedTTL": "30s"}
  },
  "clusterDomain": "cluster.local",
  "hairpinMode": "hairpin-veth",
  "readOnlyPort": 0,
  "cgroupDriver": "cgroupfs",
  "cgroupRoot": "/",
  "featureGates": {"RotateKubeletServerCertificate": "true"},
  "protectKernelDefaults": "true",
  "serializeImagePulls": "false",
  "serverTLSBootstrap": "true",
  // 暗号スイート
  "tlsCipherSuites": [
    "TLS_ECDHE_ECDSA_WITH_AES_128_GCM_SHA256",
    "TLS_ECDHE_RSA_WITH_AES_128_GCM_SHA256",
    "TLS_ECDHE_ECDSA_WITH_CHACHA20_POLY1305",
    "TLS_ECDHE_RSA_WITH_AES_256_GCM_SHA384",
    "TLS_ECDHE_RSA_WITH_CHACHA20_POLY1305",
    "TLS_ECDHE_ECDSA_WITH_AES_256_GCM_SHA384",
    "TLS_RSA_WITH_AES_256_GCM_SHA384",
    "TLS_RSA_WITH_AES_128_GCM_SHA256"
  ]
}
ユーザーデータファイル
▼ ユーザーデータファイルとは
Amazon EC2 Node の起動時に任意のコマンドを実行できるようにする。
また、セルフマネージド Node グループやマネージド Node グループにて、Amazon EC2 ワーカーNode の AWS AMI にカスタム AMI を使用したり、任意の AWS AMI で起動テンプレートを使用する場合、AWS 側で決められたコマンド (bootstrap.sh ファイル) を実行する必要がある。
一方で、マネージド Node グループにて、起動テンプレートを使用せずに Amazon EC2 ワーカーNode を作成する場合、ユーザーデータファイルを自動で作成してくれるため、これは不要である。
▼ bootstrap.sh ファイル
Amazon EC2 ワーカーNode のカスタム AMI に必要なファイルである。
Amazon EC2 ワーカーNode 起動時のユーザーデータファイル内で、bootstrap.sh ファイルに決められたパラメーターを渡す必要がある。
ユーザーデータファイル内で、bootstrap.sh ファイルにパラメーターを渡す必要がある。
#!/bin/bash

# ユーザーデータファイル

set -o xtrace

# 主要なパラメーターは以下の通り。
# その他のパラメーター:https://github.com/awslabs/amazon-eks-ami/blob/584f9a56c76fc9e7e8632f6ea45e29d45f2eab63/files/bootstrap.sh#L14-L35
#
# --b64-cluster-ca:kube-apiserverのサーバー証明書の値を設定する。
# --apiserver-endpoint:kube-apiserverのエンドポイントを設定する。
# --container-runtime:コンテナランタイムとしてcontainerdを使用する。代わりに、dockerも使用できる。

/etc/eks/bootstrap.sh foo-eks-cluster \
  --b64-cluster-ca ***** \
  --apiserver-endpoint https://*****.gr7.ap-northeast-1.eks.amazonaws.com \
  --container-runtime containerd
なお、設定可能なすべてのパラメーターは、以下から確認できる。
よく使用するパラメーター配下の通りである。
| パラメーター | 例 | 説明 |
|---|---|---|
--apiserver-endpoint |
Amazon EKS Cluster の kube-apiserver のエンドポイントを設定する。 | |
--b64-cluster-ca |
kube-apiserver のエンドポイントを設定した場合、HTTPS でリクエストするために、サーバー証明書を設定する。 | |
--container-runtime |
containerd |
コンテナランタイムの種類を設定する。 |
--kubelet-extra-args |
--node-labels=nodetype=foo --max-pods=110 |
KubeletConfiguration のデフォルト値を上書きする。 |
--use-max-pods |
false |
kubelet の --max-pods オプションを有効化するフラグを設定する。Kubelet が実行可能な Pod 数を設定する。Kubelet ではこのオプションは非推奨になっており、代わりに KubeletConfiguration に渡すようにする。 |
ユーザーデータファイル内で必要なパラメーターの注意点として、各パラメーターはハードコーディングしないようにする。
パラメーターストアにパラメーターを永続化し、ユーザーデータファイル内に出力する。
#!/bin/bash

# ユーザーデータファイル

set -o xtrace

PARAMETERS=$(aws ssm get-parameters-by-path --with-decryption --path "/eks/foo-eks-cluster")

# Clusterのサーバー証明書、kube-apiserverのエンドポイントの値をパラメーターストアから取得する。
for parameter in $(echo ${PARAMETERS} | jq -r '.Parameters[] | .Name + "=" + .Value'); do
  echo "export ${parameter##*/}"
done >> "${EXPORT_ENVS}"

# 出力する。
source "${EXPORT_ENVS}"

/etc/eks/bootstrap.sh foo-eks-cluster \
  --b64-cluster-ca $B64_CLUSTER_CA \
  --apiserver-endpoint $APISERVER_ENDPOINT \
  --container-runtime containerd
▼ Amazon EC2 ワーカーNode のコンテナイメージキャッシュ削除
kubelet は、Node のコンテナイメージのキャッシュを作成する。
コンテナイメージのキャッシュは、kubelet によるガベージコレクションまたは Node の再作成で削除される。
KubeletConfiguration の --image-gc-high-threshold オプションで、キャッシュ削除の閾値とするディスク使用率を設定する。
--image-gc-low-threshold オプションで、解放しようとするディスク使用率を設定する。
ディスク使用率が 70%を超過した場合、ディスク使用率 50%分を解放する。
#!/bin/bash

# ユーザーデータファイル

set -o xtrace

# --image-gc-high-thresholdオプションに値が既に設定されていなければ、設定を挿入する。
if ! grep -q imageGCHighThresholdPercent /etc/kubernetes/kubelet/kubelet-config.json;
then
    sed -i '/"apiVersion*/a \ \ "imageGCHighThresholdPercent": 70,' /etc/kubernetes/kubelet/kubelet-config.json
fi

# --image-gc-low-thresholdオプションに値が既に設定されていなければ、設定を挿入する。
if ! grep -q imageGCLowThresholdPercent /etc/kubernetes/kubelet/kubelet-config.json;
then
    sed -i '/"imageGCHigh*/a \ \ "imageGCLowThresholdPercent": 50,' /etc/kubernetes/kubelet/kubelet-config.json
fi

/etc/eks/bootstrap.sh foo-eks-cluster \
  --b64-cluster-ca $B64_CLUSTER_CA \
  --apiserver-endpoint $APISERVER_ENDPOINT \
  --container-runtime containerd
▼ Amazon EC2 ワーカーNode の Graceful Shutdown
デフォルトでは、Amazon EC2 ワーカーNode は新しい Pod のスケジューリングを禁止した後、Pod の退避を待たずに停止してしまう。
kubelet を使用して Amazon EC2 ワーカーNode の停止を待機し、Pod が終了する (ワーカーNode から退避させる) までの時間を稼ぐ。
ワーカーNode の停止までの待機中に終了できた Pod は、Failed ステータスとなる。
KubeletConfiguration の --shutdown-grace-period オプション (shutdownGracePeriod) で、ワーカーNode の停止を待機する期間を設定する。
また --shutdown-grace-period-critical-pods オプション (shutdownGracePeriodCriticalPods) で、特に重要な Pod の終了のために待機する時間を設定する。
InhibitDelayMaxSec には、--shutdown-grace-period オプションと同じ秒数 (単位は不要) を設定する。
注意点として、この時間が長すぎると、ワーカーNode の停止の全体時間が長くなるため、結果的にローリングアップグレードで Node の所要時間も長くなってしまう。
ワーカーNode の停止を 6 分だけ待機し、その後に停止を始める。
6 分のうち後半 2 分を、重要な Pod の停止に割り当てる。
#!/bin/bash

# ユーザーデータファイル

set -o xtrace

# --shutdown-grace-periodオプションに値が既に設定されていなければ、設定を挿入する。
if ! grep -q shutdownGracePeriod /etc/kubernetes/kubelet/kubelet-config.json;
then
    sed -i '/"apiVersion*/a \ \ "shutdownGracePeriod": "360s",' /etc/kubernetes/kubelet/kubelet-config.json
fi

# --shutdown-grace-period-critical-podsオプションに値が既に設定されていなければ、設定を挿入する。
if ! grep -q shutdownGracePeriodCriticalPods /etc/kubernetes/kubelet/kubelet-config.json;
then
    sed -i '/"shutdownGracePeriod*/a \ \ "shutdownGracePeriodCriticalPods": "120s",' /etc/kubernetes/kubelet/kubelet-config.json
fi

mkdir -p /etc/systemd/logind.conf.d
cat <<EOF > /etc/systemd/logind.conf.d/50-max-delay.conf
[Login]
InhibitDelayMaxSec=360
EOF

sudo systemctl restart systemd-logind

/etc/eks/bootstrap.sh foo-eks-cluster \
  --b64-cluster-ca $B64_CLUSTER_CA \
  --apiserver-endpoint $APISERVER_ENDPOINT \
  --container-runtime containerd
Failed ステータスの Pod は、そのままでは削除できない。
そのため、Failed ステータスな Pod を自動で削除してくれるツール (例:descheduler) や、以下のような削除コマンドを持つ CronJob を作成するとよい。
for ns in $(kubectl get namespace -o name | cut -d / -f 2); do
  echo $ns
  kubectl get pod -n $ns -o json \
    | jq -r '.items[] | select(.status.phase == "Failed") | select(.status.reason == "Shutdown" or .status.reason == "NodeShutdown" or .status.reason == "Terminated") | .metadata.name' \
    | xargs --no-run-if-empty --max-args=100 --verbose kubectl delete pod -n $ns
done
組み込みミドルウェア
▼ 時刻調整処理
Node 間の時刻が異なると、時刻をもとにした処理 (例:認証) が失敗する可能性がある。
各 Node には、時刻を正しく調整するミドルウェア (configure-clocksource) があらかじめインストールされている。
################################################################################
### Time #######################################################################
################################################################################

sudo cp -v $WORKING_DIR/shared/configure-clocksource.service /etc/systemd/system/configure-clocksource.service
sudo systemctl enable configure-clocksource
# configure-clocksource
[Unit]
Description=Configure kernel clocksource
# the script needs to use IMDS, so wait for the network to be up
Wants=network-online.target
After=network-online.target

[Service]
ExecStart=/usr/bin/configure-clocksource

[Install]
WantedBy=multi-user.target
ちなみに、タイムゾーンは timedatectl コマンドで変更できる。
$ timedatectl set-timezone America/Vancouver
09. Fargate での Pod 実行
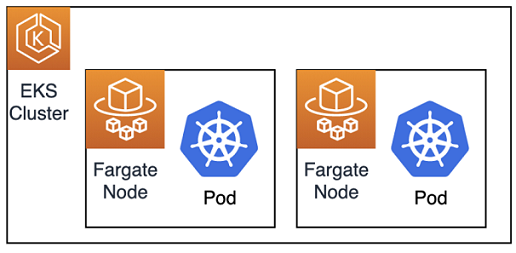
on Fargate (Fargate ワーカーNode) とは
AWS が管理する Fargate 上の実行環境を Pod ごとにワーカーNode として起動し、ユーザーが Amazon EC2 ワーカーNode を管理せずに Pod を稼働させられる。
Fargate の選択条件
▼ Amazon EC2 ワーカーNode との比較
Fargate は Amazon EC2 ワーカーNode よりカスタマイズ性が低いが、ホストの管理を AWS に任せられる。
Amazon EC2 ワーカーNode と比較して、使用できない機能については、以下のリンクを参考にせよ。
▼ Fargate ワーカーNode を使用できない場合
以下の場合は、Amazon EC2 ワーカーNode を使用する。
- Fargate ワーカーNode では、DaemonSet が使えない。サイドカーを配置する必要がある。
- Fargate で設定可能な最大スペックを超えたスペックが必要である。
- EmptyDir Volume 以外が必要である。
- Fargate ワーカーNode では、サービスメッシュに AppMesh しか使えない。もし、AppMesh を使いたくない場合は、Amazon EC2 ワーカーNode を使用する。
Fargate プロファイルによる Pod の割り当て
Fargate ワーカーNode には Node グループがなく、代わりに Fargate プロファイルを使用して、Fargate ワーカーNode にスケジューリングさせる Pod を指定する。
Fargate プロファイルの設定
Fargate を設定する。
| コンポーネント名 | 説明 | 補足 |
|---|---|---|
| Pod 実行ロール | kubelet が AWS リソースにリクエストを送信できるように、Pod にロールを設定する。 | ・実行ポリシー (AmazonEKSFargatePodExecutionRolePolicy) には、Amazon ECR への認可スコープのみが付与されている。・信頼されたエンティティでは、 eks-fargate-pods.amazonaws.com を設定する必要がある。https://docs.aws.amazon.com/eks/latest/userguide/pod-execution-role.html |
| サブネット | Amazon EKS Fargate ワーカーNode が起動するサブネット ID を設定する。 | プライベートサブネットを設定する必要がある。 |
| ポッドセレクタ (Namespace) | Amazon EKS Fargate ワーカーNode にスケジューリングさせる Pod を固定できるように、Pod の Namespace の値を設定する。 | ・kube-system や default を指定する Kubernetes リソースが稼働できるように、ポッドセレクタにこれを追加する必要がある。・Istio や ArgoCD を、それ専用の Namespace で稼働させる場合は、その Namespace のためのプロファイルを作成しておく必要がある。 |
| ポッドセレクタ (Label) | Amazon EKS Fargate ワーカーNode にスケジューリングさせる Pod を固定できるように、Pod の任意の label キーの値を設定する。 |
10. メトリクスとログの収集
コントロールプレーンの監視
▼ ログ収集
コントロールプレーンのログは、種類ごとに Amazon CloudWatch Logs への出力を有効化する。
| ログの種類 | 内容 |
|---|---|
api |
kube-apiserver の処理ログ |
audit |
Kubernetes API の監査ログ |
authenticator |
AWS IAM の資格情報による認証のログ |
controllerManager |
kube-controller-manager のログ |
scheduler |
kube-scheduler のログ |
▼ Amazon EKS Upgrade insight
非推奨 apiVersion 検出ツール (例:pluto、kubepug) のようなクライアント側からの検証ではなく、kube-apiserver 側で非推奨 apiVersion を検出する。
kube-apiserver の監査ログから非推奨 apiVersion を検出する。
クライアント # pluto で検証
↓
--- Cluster
↓
kube-apiserver
↓
etcd # Amazon EKS アップグレードインサイトで検証
Amazon EC2 ワーカーNode の監視
▼ ログ収集
| Node 上のログの場所 | 説明 |
|---|---|
/var/log/containers |
このディレクトリに、その Amazon EC2 ワーカーNode 上の Pod 内コンテナのログファイルのシンボリックリンクを作成する。 |
var/log/aws-routed-eni/ipamd.log |
このディレクトリに、Amazon VPC CNI の L-IPAM デーモンのログを出力する。 |
/var/log/aws-routed-eni/plugin.log |
Amazon EC2 のヘルスチェック
▼ Amazon EC2 に関するヘルスチェック
Amazon EC2 に関するヘルスチェック (例:Amazon EC2 の正常性) は、AWS Auto Scaling グループで設定できる。
▼ Node に関するヘルスチェック
Node に関するヘルスチェック (例:Amazon EC2 内の kubelet の正常性) は、Amazon EKS アドオンの Node 監視エージェントで設定できる。
Fargate ワーカーNode の監視
▼ データポイント収集
Fargate ワーカーNode 内のメトリクスの元になるデータポイントを収集するうえで、Fargate ワーカーNode は DaemonSet に非対応である。
そのため、データポイント収集コンテナをサイドカーコンテナとして配置する必要がある。
収集ツールとして、OpenTelemetry をサポートしている。
▼ ログ収集
Fargate ワーカーNode 内のログをフォワーディングするうえで、Fargate は DaemonSet に非対応のため、ログフォワーディングコンテナをサイドカーコンテナとして配置する必要がある。
ロググーティングツールとして、FluentBit をサポートしている。
-
ログフォワーディングコンテナのための Namespace を作成する。
名前は、必ず
aws-observabilityとする。apiVersion: v1 kind: Namespace metadata: name: aws-observability labels: aws-observability: enabled -
aws-observability内でaws-loggingという名前の ConfigMap を作成する。これにより、ログフォワーディングコンテナとしてFluentBitコンテナが作成され、PodからAmazon CloudWatch Logsにログを送信できるようになる。
名前は、必ず
aws-loggingとする。$ kubectl apply -f config-map.yaml--- apiVersion: v1 kind: ConfigMap metadata: name: aws-logging namespace: aws-observability data: output.conf: | [OUTPUT] Name cloudwatch Match * region ap-northeast-1 log_group_name fluent-bit-cloudwatch log_stream_prefix from-fluent-bit- auto_create_group true -
Fargate ワーカーNode に Amazon ECR や CloudWatch への認可スコープを持つポッド実行ロールを付与しておく。
これにより、KubernetesリソースにAWSへの認可スコープが付与され、ServiceAccountやSecretを作成せずとも、PodがAmazon ECRからコンテナイメージをプルできる様になる。
一方で、Pod内のコンテナには認可スコープが付与されない。
そのため、Podが作成された後に必要な認可スコープ (例:コンテナがRDSにリクエストを送信する認可スコープなど) には、ServiceAccountとAWS IAMロールの紐付けが必要である。
11. クラスターとワーカーNode の状態確認
ダッシュボード
-
Amazon EKS Cluster の名前を指定して、
kubeconfigファイルに Cluster の資格情報を登録する。$ aws eks update-kubeconfig --region ap-northeast-1 --name foo-eks-cluster -
kubectlコマンドの向き先を、Amazon EKS Cluster の kube-apiserver に変更する。$ kubectl config use-context <ClusterのARN> -
マニフェストを使用して、ダッシュボードの Kubernetes リソースを Amazon EKS にデプロイする。
$ kubectl apply -f https://raw.githubusercontent.com/kubernetes/dashboard/v2.0.5/aio/deploy/recommended.yaml -
ダッシュボードに安全に接続するために、ServiceAccount を Amazon EKS にデプロイする
$ kubectl apply -f service-account.yml -
トークン文字列を取得する。
$ kubectl -n kube-system describe secret $(kubectl get secret -n kube-system | grep eks-admin | awk '{print $1}') -
ローカルマシンから Amazon EKS にポートフォワーディングを実行する。
$ kubectl proxy -
ダッシュボードに接続する。
GET http://127.0.0.1:8001/api/v1/namespaces/kubernetes-dashboard/services/https:kubernetes-dashboard:/proxy/#!/login HTTP/1.1
ワーカーNode (例:Amazon EC2、Fargate) への接続
AWS SSM Session Manager を使用して、ワーカーNode (例:Amazon EC2、Fargate) に接続できる。
12. アップグレード
アップグレードとは
Amazon EKS Cluster にて、コントロールプレーンとデータプレーンをローリング方式でアップグレードする。
AWS は IaaS のため、AWS AMI を指定すれば、Node の OS のアップグレードも実施してくれる。
執筆時点 (2022/01/28) では、AWS の API を経由して updateConfig 値を設定すれば、アップグレード時のサージ数を設定できる。
アップグレードの仕組み
▼ データプレーンの場合
Amazon EKS Cluster のアップグレード時、以下の仕組みでデータプレーンのワーカーNode をローリングアップグレードする。
また、Node グループに紐づく AWS Auto Scaling グループの AZ リバランシングの仕組みによって、既存のワーカーNode と同じ AZ でワーカーNode を再作成する。
-
Node グループ単位でローリングアップグレードできるように、Amazon EKS Cluster のワーカーNode 数の設定 (Node 希望数、Node 最大数) を自動的に増加させる。
-
旧ワーカーNode を残して、新しい AWS AMI を使用したワーカーNode を作成する。
旧ワーカーNodeが稼働しているAZで新ワーカーNodeを作成する。
旧ワーカーNodeを残せるのは、あらかじめAmazon EKS ClusterのワーカーNode数の設定 (Node希望数、Node最大数) を増加させているためである。
-
各 AZ で新ワーカーNode を正しく作成できることを検証する。
-
AZ リバランシングが成功すれば、旧ワーカーNode で Drain が開始され、Pod のスケジューリングが無効化される。
-
新ワーカーNode 上で Pod をスケジューリングさせ直し、旧ワーカーNode を削除する。
-
最終的に、アップグレード前のワーカーNode 数 (Node 希望数) に戻る。
手順
▼ インプレース
Amazon EKS Cluster はおおよそ以下の方法でインプレースアップグレードする。
-
コントロールプレーン Node をアップグレードする。
-
ワーカーNode をアップグレードする。
コントロールプレーン上のkube-apiserverのバージョンに応じた新しいAWS AMIを使用して、ワーカーNodeを再作成する。
-
ワーカーNode 上の Amazon EKS アドオン (例:AWS CoreDNS、AWS kube-proxy、Amazon VPC CNI など) をアップグレードする。
▼ ブルー/グリーン
Amazon EKS Cluster はおおよそ以下の方法でブルー/グリーンアップグレードする。
-
新しいバージョン Amazon EKS クラスターを構築する。またマイクロサービスなどをデプロイする。
-
このままだと、新旧の EKS クラスターでバッチサービスの実行が衝突する。
そこで、
kubectl patch cronjobs foo-batch -p '{"spec" : {"suspend" : true }}'を実行し、旧EKSクラスターのバッチサービスを止める。 -
新しい Amazon EKS クラスターの Ingress Controller や Ingress Gateway の Pod に対して、ポートフォワーディングを実行し、アプリケーションを動作確認する。
-
既存の AWS ALB ターゲットグループにグリーン環境の Amazon EKS クラスターの Node を登録する。
-
既存の AWS ALB ターゲットグループからブルー環境の Amazon EKS クラスターの Node を解除する。
-
ワーカーNode 上の Amazon EKS アドオン (例:AWS CoreDNS、AWS kube-proxy、Amazon VPC CNI など) をアップグレードする。