データ
はじめに
本サイトにつきまして、【IT技術の知見】はじめに - 俺の技術ノート をご認識のほど宜しくお願いいたします。
01. データ型の種類
データ型のゼロ値
データ型には、値が代入されていないとき、ゼロ値が代入されている。
つまり、変数に値を設定しない限り、変数のデフォルト値はゼロ値になる。
プリミティブ型に所属するデータ型
| データ型 | 表記 | ゼロ値 |
|---|---|---|
| 数値 | int、float |
0 |
| 文字列 | string |
"" (空文字) |
| boolean 値 | boolean |
false |
合成型に所属するデータ型
構造体の場合、フィールドのゼロ値はフィールドのデータ型による。
| データ型 | 表記 | ゼロ値 |
|---|---|---|
| 構造体 | struct |
|
| 配列 | [i] |
参照型に所属するデータ型
| データ型 | 表記 | ゼロ値 |
|---|---|---|
| ポインタ | * |
nil |
| slice | [] |
nil (要素数、サイズ:0) |
| map | nil |
|
| チャネル | nil |
02. プリミティブ型のまとめ
プリミティブ型とは
// 定義 (ゼロ値として『0』が割り当てられる)
var number int

// 代入
number = 5
Defined Type によるユーザー定義のプリミティブ型
Defined Type を使用して、ユーザー定義のプリミティブ型を定義する。
元のプリミティブ型とは互換性がなくなる。
integer 型を元に、Age 型を定義する。
type Age int
パッケージの型を元に、MyAppWriter 型を定義する。
type MyAppWriter io.Writer
プリミティブ型とメモリの関係
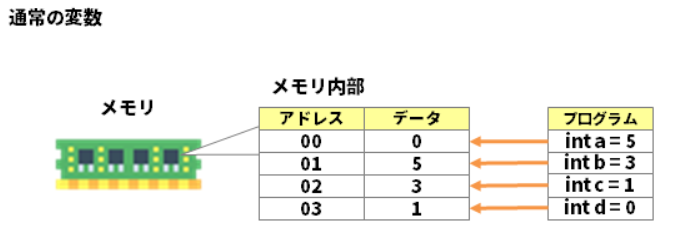
プリミティブ型の変数を定義すると、データ型のバイト数に応じて、空いているメモリ領域に、変数が割り当てられる。
1 個のメモリアドレス当たり 1 バイトに相当する。
各データ型のサイズ
| データ型 | 型名 | サイズ(bit) | 説明 |
|---|---|---|---|
| int (符号付き整数) | int8 | 8 |
|
| int16 | 16 |
||
| int32 | 32 |
||
| int64 | 64 |
||
| int | 32 or 64 |
実装環境によって異なる。 | |
| uint (符号なし整数) | uint8 | 8 |
|
| uint16 | 16 |
||
| unit32 | 32 |
||
| uint64 | 64 |
||
| uint | 32 or 64 |
実装環境によって異なる。 | |
| float (浮動小数点) | float32 | 32 |
|
| float64 | 64 |
||
| complex (複素数) | complex64 | 64 |
実部:float32、虚部:float32 |
| complex128 | 128 |
実部:float64、虚部:float64 |
03. JSON
JSON と構造体のマッピング
構造体と JSON の間でパースを実行するとき、構造体の各フィールドと、JSON のキー名を、マッピングしておける。
package main

import (
    "encoding/json"
    "log"
)

type Person struct {
    Name string `json:"name"`
}

func main() {
    person := &Person{
        Name: "Hiroki",
    }

    byteJson, err := json.Marshal(person)

    if err != nil {
        log.Printf("Failed to do something: %v", err)
        return
    }

    // エンコード結果を出力
    log.Printf("%v", string(byteJson)) // "{\"name\":\"Hiroki\"}"
}
omitempty
値が『false、0、nil、空配列、空 slice、空 map、空文字』のときに、JSON エンコードでこれを除外できる。
構造体を除外したい場合は、nil になりうるポインタ型としておく。
package main

import (
    "encoding/json"
    "log"
)

type Person struct {

    // false、0、nil、空配列、空slice、空map、空文字を除外できる。
    Id int `json:"id"`

    // 構造体はポインタ型としておく
    Name *Name `json:"name,omitempty"`
}

type Name struct {
    FirstName string `json:"first_name"`
    LastName  string `json:"last_name"`
}

func main() {
    person := &Person{
        Id: 1, // Name構造体はnilにしておく
    }

    byteJson, err := json.Marshal(person)

    if err != nil {
        log.Printf("Failed to do something: %v", err)
        return
    }

    // エンコード結果を出力
    log.Printf("%v", string(byteJson)) // "{\"id\":1}"
}
04. 配列
配列とは
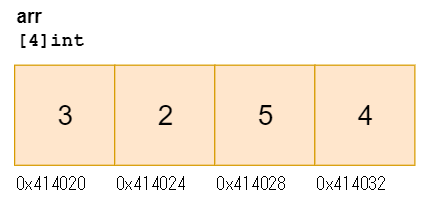
要素、各要素のメモリアドレスからなるデータのこと。
宣言と代入
配列を宣言し、変数に代入する。
宣言と代入を別々に実行する。
また、要素数の定義が必要である。
package main

import "log"

func main() {

    var z [2]string
    z[0] = "Hiroki"
    z[1] = "Gopher"

    log.Printf("%v", z) // [Hiroki Gopher]
    log.Printf("%v", z) // [2]string{"Hiroki", "Gopher"}
}
宣言と代入を同時に実行する。
また、要素数の定義が必要である。
package main

import "log"

func main() {

    var y [2]string = [2]string{"Hiroki", "Gopher"}

    log.Printf("%v", y) // [Hiroki Gopher]
    log.Printf("%v", y) // [2]string{"Hiroki", "Gopher"}
}
宣言と代入を同時に実行する。
また、型推論と要素数を省略する。
package main

import "log"

func main() {

    x := [...]string{"Hiroki", "Gopher"}

    log.Printf("%v", x) // [Hiroki Gopher]
    log.Printf("%v", x) // [2]string{"Hiroki", "Gopher"}
}
配列とメモリの関係
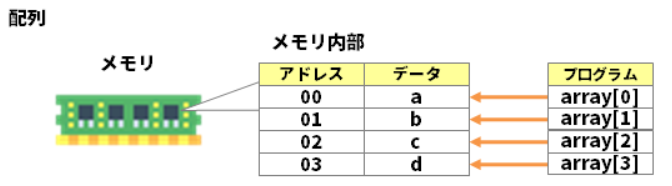
配列型の変数を定義すると、空いているメモリ領域に、配列がまとまって割り当てられる。
1 個のメモリアドレス当たり 1 バイトに相当する。
05. ポインタ
ポインタとは
メモリアドレスのこと。
ポインタ型とは
メモリアドレスを代入できるデータ型のこと。
参照演算子 (&)
定義された変数に対して、& (アンパサンド) を宣言すると、メモリアドレスを参照できる。
参照したメモリアドレス値は、ポインタ型の変数に代入する必要があるが、型推論で記述すればこれを意識しなくてよい。
package main

import "log"

func main() {
    x := "a"

    // メモリアドレスを参照する。
    var p *string = &x
    // p := &x と同じ

    // メモリアドレスを参照する前
    log.Printf("%v", x) // "a"

    // メモリアドレスを参照した後
    log.Printf("%v", p) // (*string)(0xc0000841e0)
}
間接参照演算子 (*)
ポインタ型の変数に対してアスタリスクを宣言すると、メモリアドレスに割り当てられているデータの実体を参照できる。
ポインタを使用してデータの実体を参照することを『逆参照 (デリファレンス) 』という。
package main

import "log"

func main() {

    x := "a"

    p := &x

    // メモリアドレスの実体を参照する (デリファレンス) 。
    y := *p

    // メモリアドレスを参照する前
    log.Printf("%v", x) // "a"

    // メモリアドレスを参照した後
    log.Printf("%v", p) // (*string)(0xc0000841e0)

    // メモリアドレスに割り当てられたデータ
    log.Printf("%v", y) // "a"
}
ポインタ型で扱うべきデータ型
| データ型 | ポインタ型で扱うべきか | 説明 |
|---|---|---|
| 構造体 | ⭕️ | ポインタ型として扱うと、構造体が持つメモリアドレスを処理するのみでよくなる。ポインタ型としない場合と比べて、少ないメモリ消費で構造体を扱える。 |
| slice、map、chan、 func | △ | データサイズの大きさによる。 |
| プリミティブ型 | ×️ | ポインタ型で扱うメリットはない。 |
06. slice
slice とは
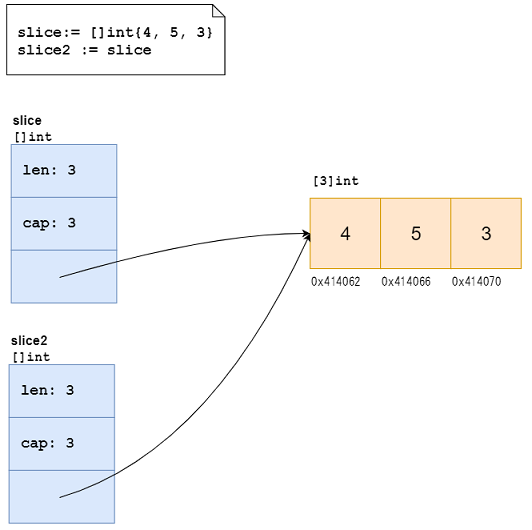
参照先の配列に対するポインタ、長さ、サイズを持つデータ型である。
// Goのコードより
type slice struct {
    array unsafe.Pointer
    len   int
    cap   int
}
宣言と代入
宣言と代入を同時に実行する。
インターフェース型を使用してもよい。
package main

import "log"

func main() {

    // var y []string = []interface{}{"Hiroki", "Gopher"} でもよい
    var y []string = []string{"Hiroki", "Gopher"}

    log.Printf("%v", y) // [Hiroki Gopher]
    log.Printf("%v", y) // []string{"Hiroki", "Gopher"}
}
文字列の宣言と代入を同時に実行する。
また、型推論する。
package main

import "log"

func main() {

    // x := []interface{}{"Hiroki", "Gopher"} でもよい
    x := []string{"Hiroki", "Gopher"}

    log.Printf("%v", x) // [Hiroki Gopher]
    log.Printf("%v", x) // []string{"Hiroki", "Gopher"}
}
バイト文字列の宣言と代入を同時に実行する。
また、型推論する。
package main

import "log"

func main() {

    // []byte{"abc"} でもよい
    x := []byte("abc")

    log.Printf("%v", x) // [97 98 99]
    log.Printf("%v", x) // []byte{0x61, 0x62, 0x63}
}
構造体の slice の宣言と代入を同時に実行する。
また、型推論する。
package main

import "log"

type Person struct {
    Name string
}

func main() {

    // []Person{{ Name: "Hiroki" }} でもよい
    person := []Person{{ Name: "Hiroki" }}

    log.Printf("%v", person) // [{Name:Hiroki}]
    log.Printf("%v", person) // []main.Person{main.Person{Name:"Hiroki"}}
}
配列の値の参照
▼ [<数値>]
slice で、指定したインデックスの値を参照する。
package main

import "log"

func main() {

    x := []string{"あ", "い", "う", "え", "お"}

    // 要素番号は0から始まることに注意する
    // 4番の要素を参照する
    xb := x[4]
    log.Printf("%v", xb) // [お]
}
▼ [<数値>:]
slice で、指定したインデックス以上の値を参照する。
package main

import "log"

func main() {

    x := []string{"あ", "い", "う", "え", "お"}

    // 要素番号は0から始まることに注意する
    // 1番目以上を参照する
    xb := x[1:]
    log.Printf("%v", xb) // [い, う, え, お]
}
▼ [:<数値>]
slice で、指定したインデックス未満の値を参照する。
package main

import "log"

func main() {

    x := []string{"あ", "い", "う", "え", "お"}

    // 要素番号は0から始まることに注意する
    // 1番目未満を参照する
    xb := x[:1]
    log.Printf("%v", xb) // [あ]
}
▼ [<数値>:<数値>]
slice で、指定したインデックスの範囲 (以上、未満) の値を参照する。
package main

import "log"

func main() {

    x := []string{"あ", "い", "う", "え", "お"}

    // 要素番号は0から始まることに注意する
    // 1番目から3番目未満 (2番目) までを参照する
    xb := x[1:3]
    log.Printf("%v", xb) // [い, う]
}
要素の追加
▼ slice に値を追加する
渡された slice で、後ろから要素を追加する。
package main

import "fmt"

func main() {
    s := []int{10, 20, 30, 40}
    fmt.Println(s) // [10 20 30 40]

    // 要素を追加。
    s = append(s, 50, 60, 70, 80)
    fmt.Println(s) // [10 20 30 40 50 60 70 80]
}
▼ slice に slice を追加する
渡された slice で、後ろから要素を追加する。
slice をアンパック (...) する必要がある。
package main

import "fmt"

func main() {
    s1 := []int{10, 20, 30, 40}
    s2 := []int{50, 60, 70, 80}

    // 要素を追加
    s := append(s1, s2...)
    fmt.Println(s) // [10 20 30 40 50 60 70 80]
}
07. map
単一のプリミティブ型を値に持つ map
▼ 文字列:任意の値
インターフェース型により、任意の型とする。
インターフェースのエイリアスである any 型でもよい。
package main

import "fmt"

func main() {
    // 『文字列:任意の値』のmap
    m := map[string]interface{}{
        "foo": "FOO",
        "bar": 1,
        "baz": true,
    }

    fmt.Println(m) // map[bar:1 baz:true foo:FOO]
}
▼ インデックス番号:文字列
map の定義と代入を同時に実行する。
package main

import "fmt"

func main() {
    // 『数値:文字列』のmap
    m := map[int]string{
        0: "Hiroki",
        1: "Hiroko",
        2: "Hiroshi",
    }

    fmt.Println(m) // map[0:Hiroki 1:Hiroko 2:Hiroshi]
}
定義と代入を別々に実行する。
package main

import "fmt"

func main() {
    // 『数値:文字列』のmap
    m := map[int]string{}

    m[0] = "Hiroki"
    m[1] = "Hiroko"
    m[2] = "Hiroshi"

    fmt.Println(m) // map[0:Hiroki 1:Hiroko 2:Hiroshi]
}
または、make() 関数を使用して map を作成もできる。
package main

import "fmt"

func main() {
    // 『数値:文字列』のmap
    m := make(map[int]string)

    m[0] = "Hiroki"
    m[1] = "Hiroko"
    m[2] = "Hiroshi"

    fmt.Println(m) // map[0:Hiroki 1:Hiroko 2:Hiroshi]
}
slice 型を値に持つ map
package main

import "fmt"

func main() {
    // 『文字列:slice』のmap
    m := map[string][]string{
        "errors": {
            0: "エラーメッセージ0",
            1: "エラーメッセージ1",
            2: "エラーメッセージ2",
        },
    }

    fmt.Println(m) // map[errors:[エラーメッセージ0 エラーメッセージ1 エラーメッセージ2]]
}
複数のデータ型を持つ map
map 型データの値をインターフェース型とすることにより、複数のデータ型を表現できる。
package main

import "fmt"

func main() {
    // 『文字列:複数のプリミティブ型』のmap
    m := map[string]interface{}{
        "id":   1,
        "name": "Hiroki Hasegawa",
    }

    fmt.Println(m) // map[id:1 name:Hiroki Hasegawa]
}
map 値の抽出
package main

import "fmt"

func main() {
    m := map[int]string{
        1: "Hiroki",
        2: "Hiroko",
        3: "Hiroshi",
    }

    // 値の抽出
    v, ok := m[1]

    // エラーハンドリング
    if !ok {
        fmt.Println("Value is not found.") // Value is not found.
    }

    fmt.Println(v) // Hiroki
}
08. nil
nil とは
いくつかのデータ型におけるゼロ値のこと。
ポインタの場合
package main

import "log"

func main() {

    x := "x"

    // ポインタ型の定義のみ
    var p1 *string

    // ポインタ型の変数を定義代入
    var p2 *string = &x

    log.Printf("%v", p1) // (*string)(nil)
    log.Printf("%v", p2) // (*string)(0xc0000841e0)
}
インターフェースの場合
package main

import "log"

func main() {
    var foo interface{}

    log.Printf("%v", foo) // <nil>
}